Introduction
Avant chaque soirée, quelqu’un chez LATEB, notre bar associatif étudiant, doit produire le planning des staffs : une ouverture découpée en créneaux d’une heure, de 18 h jusqu’à minuit, 2 h, parfois 8 h du matin, et une pile de règles à respecter. Chaque créneau doit être tenu par suffisamment de monde, mais pas trop. Il faut au moins un « respo bar » formé par créneau. Un staff présent doit tenir au moins deux ou trois heures, sans pour autant enchaîner toute la nuit, et personne ne doit être affecté sur une heure qu’il n’a pas cochée dans le sondage de disponibilités. Et idéalement, la charge devrait être équitable, et les personnes qui aiment travailler ensemble réunies. Certaines semaines comptent plusieurs soirées, donc plusieurs plannings à produire.
Fait à la main, l’exercice prend des heures et se termine invariablement par un compromis bancal : le créneau de 4 h du matin en sous-effectif, un staff qui enchaîne six heures, deux personnes qui s’évitent placées côte à côte.
Si l’exercice est aussi pénible, ce n’est pas qu’on s’y prenne mal : le problème est difficile en soi. L’affectation de personnes à des créneaux sous contraintes appartient à la famille des problèmes d’emploi du temps (timetabling), dont les versions de décision sont NP-complètes. Pour s’en convaincre : un emploi du temps réduit à sa plus simple expression, des événements à placer dans des créneaux avec des paires d’événements incompatibles, est exactement une coloration de graphe, où les événements sont les sommets, les incompatibilités les arêtes et les créneaux les couleurs. La coloration étant NP-complète (Karp, 1972), le cas général de l’emploi du temps est au moins aussi dur, et aucun algorithme connu ne trouve l’optimum en temps polynomial. Et l’espace de recherche est vertigineux : avec 24 staffs et 10 créneaux d’une heure, il existe $2^{240}$ affectations possibles, un nombre à plus de 70 chiffres. Aucune énumération, même massivement parallèle, ne s’en sortira.
La tentation est alors d’écrire un algorithme glouton : traiter les créneaux un par un, en affectant à chacun les bénévoles « les plus disponibles » ou « les moins chargés ». L’ennui, c’est qu’un choix localement raisonnable peut rendre la suite insoluble. Supposons qu’Alice soit la seule respo bar à avoir coché la fin de nuit, tout en étant aussi disponible dès l’ouverture. Un glouton qui remplit les créneaux dans l’ordre lui colle ses heures en début de soirée, atteint son maximum, puis découvre en arrivant à 4 h du matin qu’il n’y a plus de respo bar possible. Le planning est bloqué, non parce qu’il n’existait pas de solution, mais parce qu’une décision prise trop tôt a fermé la seule porte de sortie. Un glouton ne revient jamais sur ses décisions ; pour réparer ce genre d’impasse, il faut du retour arrière (backtracking), et un backtracking non informé retombe dans l’énumération exponentielle.
C’est exactement le créneau des solveurs modernes. CP-SAT, le solveur open source de la suite OR-Tools de Google, combine la résolution SAT, la programmation par contraintes et le branch-and-bound pour explorer cet espace gigantesque de façon informée : il propage les conséquences de chaque décision, apprend de ses échecs, et borne ce qu’il reste à explorer. Cet article suit ce fil : d’abord la modélisation, puis la mécanique interne, et enfin le retour d’expérience sur le générateur de planning développé pour LATEB.
Modélisation : des règles métier aux contraintes CP-SAT
Un solveur ne comprend ni « respo bar » ni « minimum d’heures ». La première étape, et la plus déterminante pour la qualité du résultat, consiste à traduire les règles métier dans le seul langage qu’il connaît : des variables à domaines finis et des contraintes sur ces variables.
Les variables de décision
Le cœur du modèle tient en une famille de variables booléennes :
$$x_{i,s} \in \{0, 1\}$$où $x_{i,s} = 1$ si et seulement si le membre $i$ est affecté au créneau $s$. Avec 24 staffs et 10 créneaux, cela fait 240 variables booléennes : c’est minuscule pour un solveur moderne, qui en avale couramment des millions.
En Python avec OR-Tools, la déclaration est directe :
|
|
Les contraintes dures
Une contrainte dure est une règle non négociable : toute affectation qui la
viole n’est pas une solution, point.
La règle R6 du cahier des charges de LATEB, « au plus max_personnes membres
par créneau », se traduit littéralement en une somme sur les variables du
créneau :
|
|
La présence d’un respo bar suit le même schéma, et la règle du minimum d’heures
montre un outil de plus : une contrainte conditionnelle, qui ne s’applique
qu’aux staffs réellement présents dans la soirée (only_enforce_if).
|
|
Les indisponibilités sont encore plus simples : si le staff $i$ n’a pas coché le créneau $s$ dans le sondage, on fixe $x_{i,s} = 0$, et la variable disparaît du problème avant même le début de la recherche.
Les contraintes souples et l’objectif pondéré
Toutes les règles ne méritent pas d’être dures, et je l’ai appris à mes dépens.
Ma première version imposait « chaque créneau doit compter au moins
min_personnes membres » comme contrainte dure, quoi de plus naturel ?
Puis est arrivée une soirée en pleine semaine de partiels, où presque personne
n’avait coché les heures de fin de nuit.
Verdict : INFEASIBLE.
J’ai passé la soirée à chercher le bug dans mon code.
Il n’y avait pas de bug : le modèle disait la vérité, aucun planning ne
satisfaisait toutes les règles.
INFEASIBLE est une réponse honnête, mais pas une réponse utile : l’association
préférerait le planning « le moins pire », avec la liste des créneaux en
sous-effectif à gérer humainement.
La solution consiste à transformer la règle en pénalité. On introduit une variable entière de « manque » par créneau, libre d’absorber le déficit, et on demande au solveur de minimiser la somme pondérée des pénalités :
|
|
Notez que la contrainte ne force le manque que dans un sens (>=) : rien
n’empêche le solveur de gonfler manque[s], mais l’objectif le pénalise, donc
il restera au minimum.
Cette « demi-réification » suffit dès que l’objectif tire la variable dans la
bonne direction, et économise des contraintes.
La distinction entre contraintes dures et souples est la décision de modélisation la plus structurante. Les contraintes dures définissent ce qu’est une solution ; l’objectif définit ce qu’est une bonne solution. On réserve donc le dur aux règles absolues (capacités physiques, obligations légales, la R6) et on met en souple tout ce qui relève de la préférence ou du souhaitable. Chaque règle passée en dur est un risque d’infaisabilité de plus ; chaque règle passée en souple est un poids de plus à calibrer.
Sous le capot : comment CP-SAT combine SAT et programmation par contraintes
Le modèle est écrit ; que fait le solveur, exactement ? CP-SAT n’est ni un solveur SAT pur, ni un solveur de programmation par contraintes classique : c’est un hybride, et sa force vient de ce mariage.
L’héritage SAT : propagation unitaire et apprentissage de clauses
Le problème SAT consiste à décider si une formule booléenne en forme normale conjonctive (une conjonction de clauses, chaque clause étant une disjonction de littéraux) admet une affectation qui la satisfait. C’est le tout premier problème démontré NP-complet (Cook, 1971). Les solveurs SAT modernes sont pourtant utilisés quotidiennement en industrie, sur des instances à plusieurs millions de variables, en vérification de matériel comme en analyse de programmes.
Leur moteur est l’algorithme CDCL (Conflict-Driven Clause Learning), qui alterne trois gestes. Il décide : il choisit une variable non affectée et lui donne une valeur, à titre d’hypothèse. Il propage : quand une clause n’a plus qu’un littéral non affecté et que tous les autres sont faux, ce littéral doit être vrai, et cette déduction en déclenche d’autres. Et parfois il se cogne : une clause devient entièrement fausse, c’est le conflit.
C’est là que CDCL se distingue d’un backtracking naïf. Au lieu de simplement revenir en arrière, le solveur analyse le conflit : il remonte le graphe des déductions pour identifier la combinaison minimale de décisions qui a mené à l’impasse, et il en déduit une nouvelle clause, dite clause apprise, qui interdit cette combinaison. Si le solveur découvre que « Alice à 20 h » et « Bob à minuit » mènent ensemble à une impasse, il apprend la clause $\lnot x_{\text{alice},20\text{h}} \lor \lnot x_{\text{bob},0\text{h}}$. Toute une région de l’espace de recherche est éliminée d’un coup, pas seulement la branche courante. Un échec ne coûte plus : il rapporte. La recherche saute ensuite directement au niveau de décision pertinent (backjumping) au lieu de défaire les décisions une par une. Ajoutez des redémarrages périodiques et des heuristiques qui privilégient les variables récemment impliquées dans des conflits, et vous obtenez un moteur qui apprend littéralement la structure de votre problème pendant qu’il le résout.
L’héritage CP : domaines, propagateurs et propagation en cascade
La programmation par contraintes attaque le problème sous un autre angle. Ses variables ne sont pas booléennes mais entières, chacune munie d’un domaine de valeurs possibles. Chaque contrainte est accompagnée d’un propagateur : un algorithme spécialisé qui retire des domaines les valeurs devenues impossibles.
Reprenons la règle du minimum (un staff présent tient au moins deux heures) et suivons ce qui se passe quand le solveur affecte Alice au créneau de 20 h, elle qui n’a coché que 20 h - 22 h. Le propagateur du minimum se réveille : Alice est désormais présente, il lui faut une deuxième heure, et la seule possible est 21 h - 22 h, donc $x_{\text{alice},21\text{h}}$ passe d’office à 1. Ce créneau atteint alors sa capacité maximale, et le propagateur de la R6 en retire Bob. Nouveau réveil, celui du propagateur du minimum de Bob : il ne lui reste qu’un seul créneau coché dans la soirée, impossible d’y faire deux heures, donc Bob sort entièrement du planning. Une seule décision, Alice à 20 h, vient de déterminer une demi-douzaine de variables par pur raisonnement, sans explorer la moindre branche. C’est la propagation en cascade : chaque déduction peut en déclencher d’autres, et les propagateurs tournent jusqu’à un point fixe, l’état où plus aucun n’a rien à déduire. Si des variables restent alors indéterminées, il fait un nouveau choix et recommence.
La propagation seule ne suffit presque jamais à résoudre le problème, mais elle réduit drastiquement l’arbre de recherche : chaque valeur retirée d’un domaine, ce sont des milliers de branches qui ne seront jamais explorées.
Le mariage des deux : la génération paresseuse de clauses
Prenons un conflit concret, sur un problème bien plus petit qu’un planning mais
fait des mêmes ingrédients.
Cinq variables entières $x_1, \dots, x_5$, chacune entre 1 et 5 : disons cinq
tâches à placer chacune sur une heure.
Trois contraintes : les tâches 1 à 4 doivent être sur des heures toutes
différentes (AllDifferent), la tâche 2 ne peut pas passer après la tâche 5
($x_2 \le x_5$), et les heures des tâches 1 à 4 ne doivent pas totaliser plus de
9 ($x_1+x_2+x_3+x_4 \le 9$).
Voici la trace de la recherche, du premier choix jusqu’au conflit :
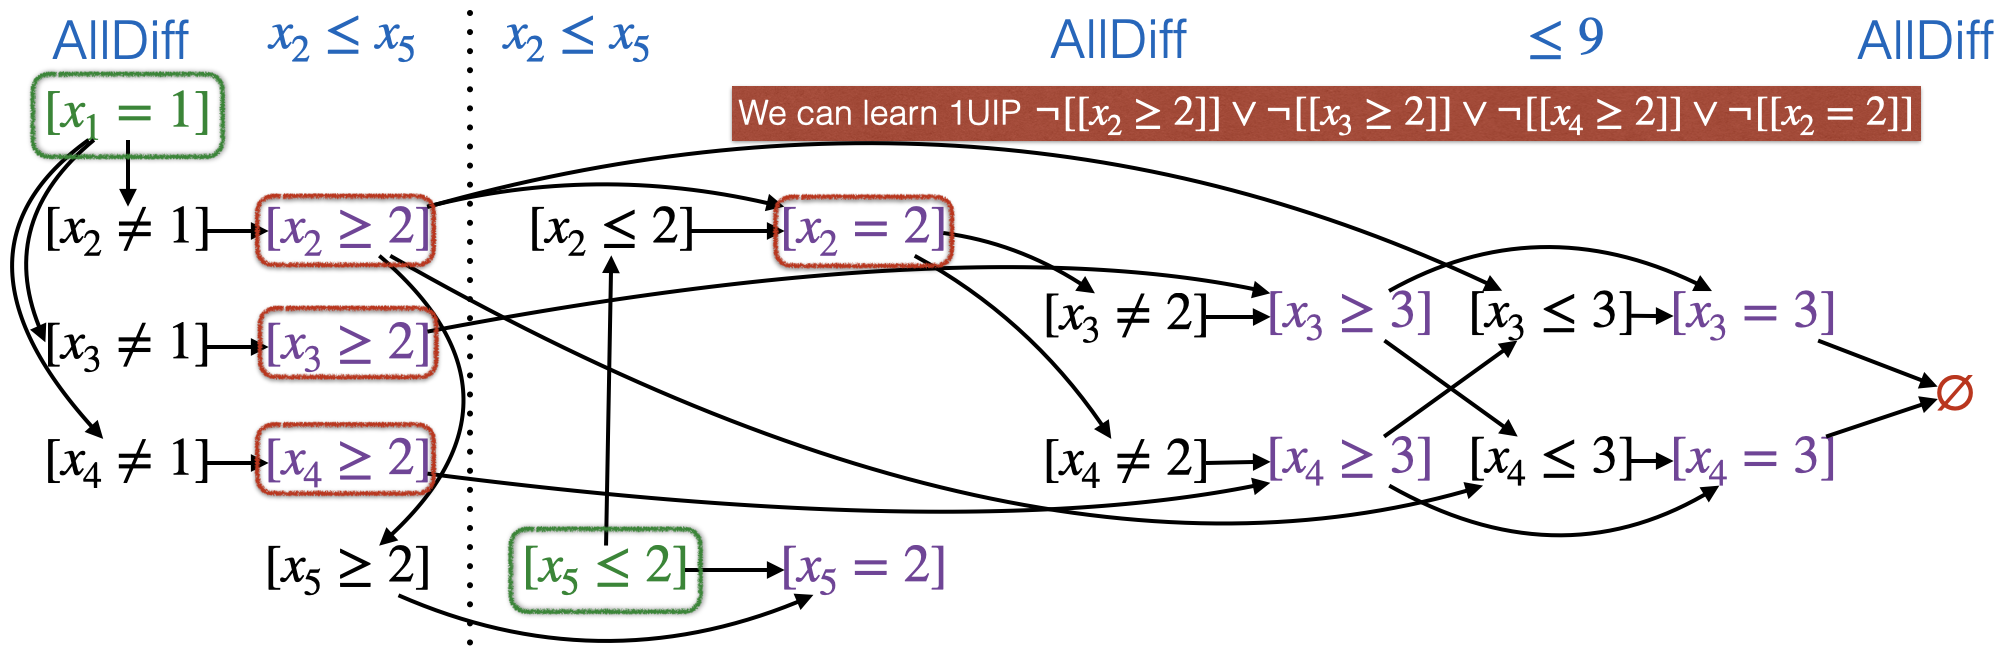
Figure tirée du CP-SAT Primer de Dominik Krupke (CC BY 4.0), d’après un exemple présenté dans un exposé de Peter Stuckey.
Ce graphe a une particularité.
On y reconnaît tout l’attirail de CDCL : des implications, un conflit
($\varnothing$), une clause apprise dans le bandeau rouge.
Mais les littéraux ne sont pas de simples booléens : ce sont des affirmations
sur des entiers, comme $[x_2 \ge 2]$ ou $[x_3 = 3]$, et les en-têtes bleus
portent des noms de contraintes, AllDiff ou $\le 9$.
D’où sortent ces clauses ?
Des propagateurs. C’est toute l’idée de la génération paresseuse de clauses (lazy clause generation, LCG), la famille de solveurs à laquelle appartient CP-SAT : un moteur CDCL au cœur du solveur, et les propagateurs de la programmation par contraintes branchés dessus. Les variables entières sont représentées, à la demande, par des littéraux booléens de la forme $[x \le v]$ ou $[x = v]$ ; « paresseuse » signifie qu’on ne crée ces littéraux que lorsqu’ils deviennent utiles. Surtout, chaque propagateur doit expliquer ses déductions : quand le propagateur de la R6 retire Bob du créneau de 21 h, il fournit une explication logique (la combinaison d’affectations qui a forcé sa déduction) que l’analyse de conflit de CDCL exploite ensuite, au même titre que les clauses ordinaires, pour construire ses clauses apprises. Relisez le schéma avec cette clé : les littéraux verts sont les décisions de recherche, chaque flèche est une implication ajoutée paresseusement par un propagateur, et la cascade mène au conflit dont l’analyse produit la clause apprise. Un raisonnement métier vient d’être mémorisé, réutilisable dans tout le reste de la recherche.
Chaque moitié compense la faiblesse de l’autre : les propagateurs apportent le raisonnement de haut niveau sur les contraintes métier (sommes, minimums, capacités) que le SAT pur encoderait en une myriade de clauses illisibles, et le moteur CDCL apporte l’apprentissage, qui évite de refaire la même erreur ailleurs dans l’arbre.
Et l’optimisation ? Relaxation linéaire et branch-and-bound
SAT et CP répondent à la question « existe-t-il une solution ? ». Notre planning demande davantage : la meilleure solution au sens de l’objectif pondéré.
CP-SAT utilise une approche de type branch-and-bound. Dès que le solveur trouve une solution de coût $V$, il ajoute la contrainte « objectif $< V$ » et continue la recherche : toute solution future devra faire strictement mieux. Les solutions s’améliorent par paliers, jusqu’à ce que le solveur prouve qu’aucune meilleure n’existe ; la dernière trouvée est alors optimale.
Pour accélérer cette preuve, CP-SAT s’appuie sur une idée empruntée au monde continu : la relaxation linéaire. Relâcher le modèle consiste à autoriser temporairement les variables à prendre des valeurs fractionnaires : $x_{i,s} = 0{,}5$ signifierait « Alice tient la moitié du créneau », ce qui n’a aucun sens métier, mais transforme le problème combinatoire en un programme linéaire continu, résoluble efficacement par l’algorithme du simplexe. Or toute vraie solution en 0/1 est aussi une solution du problème relâché : l’optimum relâché est donc nécessairement meilleur ou égal à l’optimum entier. C’est une borne inférieure gratuite. Si la meilleure solution entière trouvée coûte 42 et que la relaxation prouve qu’on ne peut pas descendre sous 42, la preuve d’optimalité est immédiate. L’écart entre les deux, le gap, mesure à tout instant ce qui reste à prouver.
Enfin, CP-SAT exploite le parallélisme de façon originale : plutôt que de paralléliser une seule recherche, il lance un portefeuille de travailleurs configurés différemment (recherche agressive sur l’objectif, recherche orientée faisabilité, relaxation linéaire, voisinages aléatoires) qui partagent en continu leurs clauses apprises, leurs solutions et leurs bornes.
En quoi est-ce différent d’un solveur ILP classique ?
On peut résoudre le même planning avec un solveur de programmation linéaire en nombres entiers (ILP) comme Gurobi ou CBC ; le modèle mathématique serait d’ailleurs presque identique. La mécanique interne, elle, diffère profondément. Un solveur ILP vit dans le monde continu : il résout des relaxations linéaires par le simplexe, branche sur les variables à valeur fractionnaire, et resserre la relaxation avec des plans coupants. CP-SAT vit dans le monde discret : domaines entiers, propagation logique, apprentissage de clauses.
En pratique, l’ILP excelle quand le problème a une forte structure numérique (flux, mélanges, coûts continus), tandis que CP-SAT brille quand le problème est dense en logique combinatoire : implications, exclusions, « au plus un », comme notre planning. Une conséquence concrète pour le modélisateur : CP-SAT ne manipule que des entiers, et des poids comme 1,5 doivent être mis à l’échelle avant d’entrer dans le modèle.
- Pour donner un ordre de grandeur, j’ai porté l’instance de l’étude de cas
- ci-dessous en MIP et je l’ai donnée à CBC, le solveur ILP open source d’OR-Tools
- même optimum, prouvé en 18 ms, contre 43 ms pour CP-SAT. À la taille d’une soirée LATEB, le choix du solveur n’a donc aucune importance ; les différences de mécanique interne ne se paient que sur des instances plus grosses ou plus denses en logique.
Info
Et les métaheuristiques ? Face à un planning, on pense aussi aux algorithmes génétiques, au recuit simulé ou à la recherche locale. Ces méthodes améliorent itérativement des solutions candidates, sans garantie : elles ne prouvent jamais l’optimalité et, quand elles ne trouvent rien, ne savent pas dire si c’est parce qu’aucune solution n’existe. En échange, elles restent utilisables sur des instances énormes où les méthodes exactes s’essoufflent. CP-SAT brouille d’ailleurs la frontière : certains de ses travailleurs parallèles font de la recherche à grand voisinage (LNS), une forme de recherche locale guidée par le solveur exact lui-même.
Étude de cas : le solveur de planning de LATEB
Revenons à LATEB avec ces outils en main. Le scheduler prend en entrée le sondage de disponibilités de la soirée (le tableau où chaque staff coche les heures où il peut venir), la liste des respos bar et les paires d’affinités déclarées ; il produit le planning de l’ouverture à la fermeture. Le cœur du modèle est celui construit dans la partie modélisation : les quelque 240 variables $x_{i,s}$, les contraintes dures de capacité (R6), de respo bar, de minimum d’heures et d’indisponibilité, et un objectif pondéré à trois étages (couverture, équité, affinités). Les deux derniers étages méritent qu’on s’y attarde : c’est là que la modélisation devient un artisanat.
L’équité, ou comment linéariser une intuition
« La charge doit être répartie équitablement » est une phrase que tout le monde comprend et qu’aucun solveur n’accepte telle quelle. Il faut choisir une définition calculable. Celle retenue : minimiser l’écart entre le staff le plus chargé et le moins chargé, parmi ceux ayant coché au moins un créneau.
|
|
La restriction « parmi ceux ayant coché au moins un créneau » n’était pas dans
ma première version, et son absence m’a coûté une heure de perplexité.
Un membre qui ne venait pas ce soir-là n’avait rien coché, donc n_min restait
cloué à zéro, et le déséquilibre valait structurellement n_max : le terme
d’équité ne pouvait plus rien optimiser, et le planning qui sortait concentrait
les heures sur une poignée de volontaires, en toute légalité vis-à-vis du
modèle.
Le solveur fait exactement ce qu’on lui demande : c’est sa plus grande qualité,
et le plus sûr moyen de se faire piéger.
Même corrigé, ce choix a des angles morts. Minimiser l’écart max-min ne « voit » que les deux extrêmes : entre deux plannings de même écart, le solveur est indifférent à la répartition du milieu. Une alternative plus fine est de minimiser la somme des écarts à une cible individuelle, ce qui lisse toute la distribution mais demande une variable d’écart absolu par membre. Pour une vingtaine de staffs par soirée, l’écart max-min s’est révélé suffisant, et bien plus simple à expliquer aux membres qui demandent pourquoi ils font trois heures quand d’autres n’en font que deux.
Les affinités, et le prix des variables auxiliaires
Pour chaque paire de membres $(i, j)$ ayant déclaré une affinité et chaque créneau $s$, on introduit une variable booléenne vraie lorsque les deux sont affectés ensemble :
|
|
Là encore, la demi-réification suffit : comme l’objectif récompense ensemble,
le solveur le mettra à 1 dès que les deux contraintes le permettent.
Le vrai coût est ailleurs : une variable et deux contraintes par paire et par
créneau, soit 150 variables auxiliaires ici.
Négligeable ici, mais ce terme croît plus vite que tout le reste du modèle, et
sur de grandes instances ce sont typiquement ces contraintes « de confort » qui
font exploser les temps de résolution.
Le réglage des poids : une hiérarchie plutôt qu’un dosage
La première version du scheduler avait des poids choisis au doigt mouillé : couverture à 10, équité à 5, affinités à 3. Le premier planning généré laissait le créneau de 4 h du matin en sous-effectif, parce que la pénalité de 10 était plus que compensée par quatre paires d’amis réunies plus tôt dans la soirée, à 3 points de bonus chacune. Mathématiquement irréprochable ; humainement indéfendable.
Quand les critères ont des priorités claires, on ne les dose pas : on les hiérarchise. Avec au plus 150 bonus d’affinité à 1 point et un déséquilibre borné par 10, poser $P_{\text{affinité}} = 1$, $P_{\text{équité}} = 200$ et $P_{\text{couverture}} = 5,000$ garantit qu’aucune accumulation de bonus d’affinité ne justifiera jamais de dégrader l’équité, et qu’aucun gain d’équité ne justifiera jamais un créneau découvert.
Tip
La règle à retenir pour hiérarchiser des critères : choisir chaque poids strictement supérieur à la somme des contributions maximales de tous les critères moins prioritaires. L’objectif pondéré se comporte alors comme un ordre lexicographique (les critères sont optimisés par priorité décroissante) en un seul appel au solveur.
Ce que ça donne
La première fois que le solveur m’a rendu un planning complet, j’ai cherché l’erreur : tous les créneaux couverts, des charges équilibrées, les affinités respectées. Aucun de nos plannings faits main n’avait jamais eu cette tête-là.
Sur une soirée reconstituée (20 staffs avec des fenêtres de disponibilité
réalistes, 10 créneaux d’une heure, 5 respos bar, 15 paires d’affinités, les
poids ci-dessus), CP-SAT rend l’optimum prouvé en 43 millisecondes sur un
ordinateur portable.
Voici le résumé que renvoie solver.response_stats(), abrégé :
|
|
Toute la mécanique décrite sous le capot est là, chiffrée, avec deux surprises.
La première est la ligne booleans : des quelque 200 variables du modèle, il
n’en reste que 83 après la phase de présolve, qui a éliminé d’office tout ce que
les indisponibilités fixaient.
La seconde est conflicts: 0 : à cette taille, la propagation fait presque tout
le travail (un bon millier de déductions pour 174 branchements), et le moteur
d’apprentissage de clauses n’a même pas eu à servir.
L’objectif se décode avec nos poids :
$4991 = 5,000 \times 1 + 200 \times 0 - 9$, soit un créneau à une personne sous
le minimum, une équité parfaite et neuf paires d’affinité réunies.
Et l’égalité entre objective et best_bound est exactement la preuve
d’optimalité décrite plus haut : la meilleure solution trouvée a rejoint la
borne inférieure.
Le planning tient toutes les contraintes dures, garde un écart de charge nul et réunit neuf paires sur quinze ; seule une heure creuse reste une personne sous le minimum souhaité, faute de volontaires ayant coché ce créneau. Là où la version manuelle coûtait des heures de négociations, la version solveur coûte le temps de relire le résultat.
Limites et perspectives
Il serait malhonnête de conclure sans parler de ce que le solveur ne garantit pas.
Le temps de résolution et le filet de sécurité
Le scheduler impose une limite de 15 secondes :
|
|
CP-SAT est un algorithme anytime : interrompu, il rend la meilleure solution
rencontrée jusque-là.
Le statut distingue OPTIMAL (optimalité prouvée) de FEASIBLE (une solution
existe, mais la preuve n’a pas abouti dans le temps imparti).
Dans le second cas, solver.best_objective_bound donne la borne inférieure
atteinte, donc le gap : savoir qu’on est au pire à 2 % de l’optimum vaut souvent
mieux qu’attendre dix minutes la preuve exacte.
Sur une soirée seule, on en est très loin (43 ms sur l’instance de l’étude de
cas) : la limite est un filet de sécurité, qui ne servira que si le modèle
grossit.
Et même atteinte, elle rend une solution en pratique très bonne, car CP-SAT
trouve vite de bonnes solutions et passe l’essentiel du temps sur la preuve.
Le passage à l’échelle
Une soirée, même longue, reste une petite instance : la plus grosse ouverture de l’année (24 staffs, une nuit complète de 10 créneaux) tient en 240 variables principales. Les choses se corsent si l’on veut planifier d’un coup toutes les soirées du mois avec une équité entre soirées : le produit staffs × créneaux × soirées grimpe vite, et les termes d’affinité, qui croissent avec le produit paires × créneaux, encore plus vite. L’autre ennemi du passage à l’échelle est plus sournois : la symétrie. Si Alice et Bob ont coché les mêmes heures et ont le même rôle, alors « Alice de 20 h à 22 h, Bob de 22 h à minuit » et l’échange inverse sont deux solutions distinctes aux yeux du solveur, mais rigoureusement identiques aux yeux de l’association. Chaque groupe de bénévoles interchangeables démultiplie ainsi les variantes, et le solveur peut perdre un temps considérable à explorer des plannings indistinguables, surtout au moment de prouver l’optimalité. Des contraintes de bris de symétrie (imposer un ordre arbitraire entre membres interchangeables) sont alors le remède classique.
Quand l’optimum n’est pas trouvé, et ce qu’on peut y faire
Trois pistes rendent le système plus robuste quand les instances grossissent ou
que les replanifications s’enchaînent.
La première est le démarrage à chaud : quand un staff se désiste une heure avant
l’ouverture, on passe le planning courant comme indice via add_hint, et le
solveur converge presque instantanément vers un planning proche de l’existant
(ce que les membres préfèrent de toute façon).
La deuxième est le diagnostic d’infaisabilité : en résolvant sous hypothèses
(assumptions), on peut demander au solveur quelles contraintes sont en
conflit, et remplacer un INFEASIBLE opaque par un message exploitable, du type
« aucun respo bar n’a coché les créneaux après 2 h ».
La dernière est la décomposition : pour équilibrer la charge sur le mois,
résoudre soirée par soirée en reportant l’historique de chacun dans l’objectif
d’équité, plutôt que de tout résoudre d’un bloc.
Au final, le solveur n’a jamais été la partie difficile de ce projet. La modélisation, si. Choisir ce qui est dur et ce qui est souple, linéariser une intuition d’équité, hiérarchiser des poids : c’est là que se joue la qualité du planning. Et le même schéma de modélisation (des variables de décision, des contraintes dures, des préférences pondérées) se retrouve bien au-delà des soirées d’un bar associatif : emplois du temps scolaires, tournées de véhicules, ordonnancement d’ateliers, allocation de ressources dans le cloud, jusqu’à l’ordonnancement d’instructions dans un compilateur. De ce projet, c’est la compétence que je garde : savoir découper un problème en variables, contraintes et préférences, puis laisser le solveur faire le sale boulot.
Pour aller plus loin
- The CP-SAT Primer de Dominik Krupke, la référence pratique la plus complète sur CP-SAT.
- La documentation OR-Tools et ses exemples de scheduling.
- O. Ohrimenko, P. J. Stuckey, M. Codish, Propagation via Lazy Clause Generation, Constraints 14, 2009 : l’article fondateur, et l’exposé de P. Stuckey qui le vulgarise.
- J. Marques-Silva, I. Lynce, S. Malik, Conflict-Driven Clause Learning SAT Solvers, in Handbook of Satisfiability, IOS Press, pour creuser CDCL.
Note
Article en cours de rédaction, plan validé par G. Legourriérec (06/07/2026).