Table des matières
- Introduction
- 1999 : le problème C10K
- select et poll : le multiplexage première génération
- epoll : rendre l’intérêt persistant
- Sous le capot : le travail du kernel
- Les pièges d’epoll
- epoll en pratique : 10 000 timers
- De epoll à l’event loop
- Conclusion : les limites du modèle readiness
- Bibliographie
Introduction
Ouvrez un gestionnaire de tâches sur n’importe quel serveur web moderne et vous y trouverez une poignée de processus nginx (généralement moins d’une dizaine) servant tranquillement des dizaines de milliers de connexions simultanées.
Un seul thread gérant des milliers de clients.
Cette banalité d’aujourd’hui était une impossibilité pratique il y a plus de vingt-cinq ans, et ce qui a tout changé repose sur un mécanisme du kernel Linux dont peu de développeurs connaissent le fonctionnement : epoll.
Cet article s’adresse aux étudiants et ingénieurs qui ont des bases en programmation système, vous savez ce qu’est un descripteur de fichier (file descriptor) et un appel système (syscall) mais vous n’avez jamais exploré le multiplexage d’entrées/sorties (I/O multiplexing).
À la fin de cet article, vous saurez pourquoi le modèle historique « un thread par connexion » s’effondre à grande échelle, pourquoi ses premiers remplaçants select et poll ne suffisaient pas, et surtout comment epoll fonctionne réellement, jusque dans les structures de données du kernel.
Vous comprendrez alors pourquoi nginx, Node.js ou Redis sont architecturés comme ils le sont.
Ce ne sont pas des choix de style, ce sont les conséquences directes d’un mécanisme kernel inventé en 2002.
1999 : le problème C10K
Un serveur réseau passe l’essentiel de sa vie à attendre. Attendre qu’un client envoie sa requête, attendre que le réseau accepte les octets de la réponse. La question la plus importante du design de serveurs n’est donc pas « comment calculer le plus rapidement possible », mais « comment attendre efficacement sur des milliers de connexions à la fois ».
La réponse historique, celle des serveurs web des années 90 comme National Center for Supercomputing Applications (NCSA) HTTPd puis Apache, était d’une grande simplicité : un processus ou un thread par connexion.
Chaque connexion obtient son thread, qui exécute un read() bloquant et le kernel endort le thread jusqu’à l’arrivée de données.
Le code est linéaire, facile à écrire, facile à raisonner. Et il fonctionne parfaitement… jusqu’à quelques centaines de connexions.
Au-delà, trois coûts explosent.
En premier lieu, la mémoire. Chaque thread possède sa propre stack, environ 8 Mo d’espace virtuel par défaut sur Linux, dont plusieurs dizaines de Ko réellement résidents. À 10 000 connexions, on consomme des centaines de Mo simplement pour exister, sur des machines qui, en 1999, disposaient rarement de plus d’un ou deux Go de RAM.
Ensuite l’ordonnanceur (ou le scheduler) doit arbitrer entre 10 000 entités, et chaque réveil implique un changement de contexte, une sauvegarde et une restauration des registres, une pollution des caches CPU et du TLB. À haute fréquence, le processeur passe plus de temps à changer de thread (context switch) qu’à servir des clients.
Enfin, la synchronisation devient un enfer, des milliers de threads partageant des structures communes multiplient les verrous et les réveils inutiles.
C’est ce constat que Dan Kegel, un ingénieur logiciel et développeur, formalise en 1999 dans une page web intitulée « The C10K problem ». Son argument central est une véritable pique adressée aux développeurs puisqu’il maintient que le matériel n’est pas le coupable.
En effet, une machine à 1000 MHz à environ 1 200 dollars de l’époque avec 2 Go de RAM et une carte ethernet 1 gigabit devrait mathématiquement pouvoir servir 10 000 clients simultanés. Et l’un des sites FTP les plus fréquentés de l’époque, ftp.cdrom.com 1, le prouvait déjà en production. Si les serveurs s’écroulaient bien avant, c’est que le logiciel ne suivait pas, les modèles de programmation, et surtout les API que les systèmes d’exploitation offraient pour attendre. Le C10K n’est pas un problème de puissance. C’est un problème d’interface entre l’application et le kernel.
select et poll : le multiplexage première génération
L’alternative au thread-par-connexion existait pourtant depuis déjà quelque temps.
En effet on pouvait déjà utiliser le multiplexage d’entrées/sorties.
L’idée est de renverser le modèle.
Ici, un seul thread surveille tous les descripteurs, et ne s’occupe que de ceux qui sont prêts.
Les fds (file descriptors) sont configurés en mode non-bloquant, et un appel système central répond à la question « lesquels de ces descripteurs peuvent être lus ou écrits sans bloquer ? ».
L’appel système select(), apparu dans 4.2BSD en 1983, est l’ancêtre d’epoll.
On lui passe trois ensembles de descripteurs (lecture, écriture, conditions exceptionnelles) et il bloque jusqu’à ce qu’au moins un fd soit prêt, puis signale lesquels en modifiant les ensembles fournis.
Le premier problème inhérent à select est très simple mais rédhibitoire pour notre cas.
En effet, fd_set (le type des paramètres donnés précédemment) est un bitmap de taille fixe, et la constante FD_SETSIZE vaut 1024 sur Linux.
Pour un problème qui s’appelle C10K, un plafond de 1024 connexions nous oblige d’entrée de jeu à changer d’outil.
C’est ainsi que poll(), hérité de System V (1986) et introduit dans la version 2.1.23 de Linux en 1997, corrige ce point avec un tableau de struct pollfd de taille arbitraire.
Mais poll ne corrige pas le second défaut, qui est le vrai problème.
Ces deux API sont dites stateless (sans état).
Par conséquent, le kernel ne mémorise rien entre deux appels et à chaque itération de la boucle du serveur, il faut lui retransmettre la liste complète des descripteurs surveillés.
Concrètement, chaque appel implique :
- la copie du tableau entier depuis l’espace utilisateur vers le kernel
- le parcours par le kernel de chaque descripteur pour interroger son état
- la recopie du résultat vers l’espace utilisateur
- puis le parcours par l’application de ce résultat pour retrouver les fds prêts.
Le coût de chaque appel est donc en O(n), où n est le nombre de descripteurs surveillés.
Cependant, l’information utile est proportionnelle au nombre de descripteurs prêts donc si vous devez surveiller 10 000 connexions dont une seule est active, vous devez quand même parcourir les 10 000 fds à chaque tour de boucle.
Or, un serveur occupé fait des milliers de tours de boucle par seconde.
On se rend alors très vite compte que le coût devient imposant et que n descripteurs × milliers d’appels dévore littéralement le CPU.
L’article « Epoll evolving » de LWN (anciennement pour Linux Weekly News) résume le problème en une simple phrase :
« Chaque appel pouvant porter sur un ensemble entièrement nouveau de descripteurs, le kernel doit revalider chacun d’eux, vérifier son état, et s’inscrire sur sa file d’attente et cela à chaque fois. »
Toute l’invention d’epoll tient dans le renversement de cette phrase.
epoll : rendre l’intérêt persistant
Nous arrivons au cœur de l’article. epoll(7), pour event poll, est écrit par Davide Libenzi, un développeur logiciel italien, et est intégré au kernel Linux 2.5.44 en octobre 2002, puis stabilisé avec la série 2.6 en 2003.
L’idée n’était pas entièrement neuve puisque FreeBSD avait ouvert la voie dès 2000 avec kqueue, fondé sur la même intuition, et Windows disposait de IOCP (I/O Completion Ports) depuis les années 90.
Chaque système a eu sa réponse au C10K, mais epoll est celle de Linux, et c’est la domination de Linux sur les serveurs qui lui a donné son impact.
L’intuition d’epoll vient du fait que le problème de select et poll n’est pas leur implémentation mais leur contrat.
Ce contrat oblige l’application à répéter au kernel, à chaque appel, une information qu’il pourrait mémoriser (« voici les descripteurs qui m’intéressent »).
epoll casse ce contrat, en faisant de l’interest list (la liste d’intérêt aussi appelée epoll set) un objet kernel persistant, manipulé par trois appels système.
Le premier appel, epoll_create1() crée une epoll instance (instance d’epoll) dans le kernel et retourne un file descriptor qui la représente.
Le choix est très unixien puisque tout est fichier, y compris le mécanisme de surveillance des fichiers.
Ce choix a des conséquences plutôt élégantes, comme la possibilité de surveiller une instance epoll depuis une autre.
Le deuxième syscall, epoll_ctl(epfd, op, fd, event) enregistre (EPOLL_CTL_ADD), modifie (EPOLL_CTL_MOD) ou retire (EPOLL_CTL_DEL) un descripteur de la liste d’intérêt de l’instance grâce à l’argument op.
C’est l’appel qui porte l’état, on le fait donc une seule fois par connexion, typiquement à son ouverture, et le kernel s’en souvient jusqu’à sa fermeture.
Enfin le dernier appel, epoll_wait(epfd, events, maxevents, timeout) bloque jusqu’à ce que des descripteurs soient prêts, et remplit un tableau contenant uniquement ceux-là.
Pas de liste à retransmettre, pas de résultat à filtrer puisque la réponse du kernel est exactement l’information utile.
Par ailleurs, le déplacement de coût est le cœur de l’argument.
En effet, l’enregistrement coûte O(log n) (nous verrons plus loin pourquoi) mais n’a lieu qu’une fois par connexion.
L’attente, elle, ne dépend plus du tout de n puisqu’avec 10 000 connexions dont 100 actives, epoll_wait fait un travail proportionnel à 100.
Le coût par événement devient constant.
Reste à comprendre comment le kernel réussit ce tour de force car annoncer une complexité de O(1) est facile, mais l’implémenter l’est beaucoup moins.
Sous le capot : le travail du kernel
Une instance epoll est représentée dans le kernel par une structure (struct eventpoll, définie dans fs/eventpoll.c) qui s’articule autour de trois éléments principaux.
Le premier est l’interest list (la liste d’intérêt), implémentée comme un arbre rouge-noir dont chaque nœud (un epitem) représente un descripteur enregistré.
L’arbre rouge-noir est un arbre binaire de recherche auto-équilibré, c’est-à-dire qu’il garantit que l’insertion, la suppression et la recherche restent en O(log n) quel que soit le nombre d’éléments.
C’est lui qui rend epoll_ctl aussi efficace et permet à une même instance de surveiller des centaines de milliers de descripteurs, ainsi que de détecter en un clin d’œil les enregistrements en double.
Le deuxième est la ready list, c’est une simple liste chaînée contenant les descripteurs devenus prêts depuis la dernière consultation.
Enfin le troisième élément est une wait queue (file d’attente) où s’endorment les threads bloqués dans epoll_wait.
Mais aucune de ces structures n’explique à elle seule le O(1).
La vraie astuce d’epoll est ailleurs : dans le renversement du flux d’information.
Avec select et poll, le kernel est interrogé avec une question du type « ce descripteur est-il prêt ? », question posée n fois par appel.
Avec epoll, le kernel notifie.
Au moment où un descripteur est enregistré via epoll_ctl, epoll accroche une fonction de rappel (ep_poll_callback) à la wait queue de ce descripteur.
Cette wait queue n’a rien de spécifique à epoll puisque c’est tout simplement la file d’attente standard que chaque fichier ouvert possède dans le kernel, celle-là même qui sert à réveiller un thread endormi dans un read() bloquant. epoll se contente d’y inscrire, à la place d’un thread, un morceau de code.
Suivons alors le chemin complet d’un événement.
Premièrement, un paquet arrive sur la carte réseau.
La pile TCP/IP du kernel le traite et dépose les données dans le buffer de réception du socket destinataire.
En marquant ce socket comme lisible, elle réveille sa wait queue (opération de routine du kernel).
Mais parmi les « dormeurs » de cette file se trouve le callback d’epoll.
Celui-ci s’exécute immédiatement, dans le contexte du traitement de l’événement, il ajoute l’epitem correspondant à la ready list de l’instance, puis réveille les threads endormis dans epoll_wait.
Quand epoll_wait rend la main à l’application, il n’a eu qu’à vider la ready list dont la longueur est, par construction, le nombre de descripteurs prêts.
Le point conceptuel principal réside dans le fait que le travail est effectué au moment où l’événement se produit, et non au moment où l’on pose la question.
select et poll payent le coût de la surveillance à chaque interrogation contrairement à epoll qui le paye à chaque événement.
Et comme un événement ne concerne qu’un seul descripteur, le coût par événement est constant.
C’est l’équivalent logiciel du passage du polling aux interrupts (interruptions matérielles) mais implémenté à l’intérieur même du kernel, en réutilisant une structure (la wait queue) qui existait déjà.
Les pièges d’epoll
epoll offre deux sémantiques de notification, et leur différence est le piège à connaître du mécanisme.
Le premier mode est le mode level-triggered (LT).
C’est le comportement par défaut et il est identique à celui de poll.
Tant que le descripteur est prêt (tant qu’il reste des données à lire), epoll_wait le signale à chaque appel.
Vous pouvez ne lire qu’une partie des données et revenir plus tard et epoll vous le rappellera.
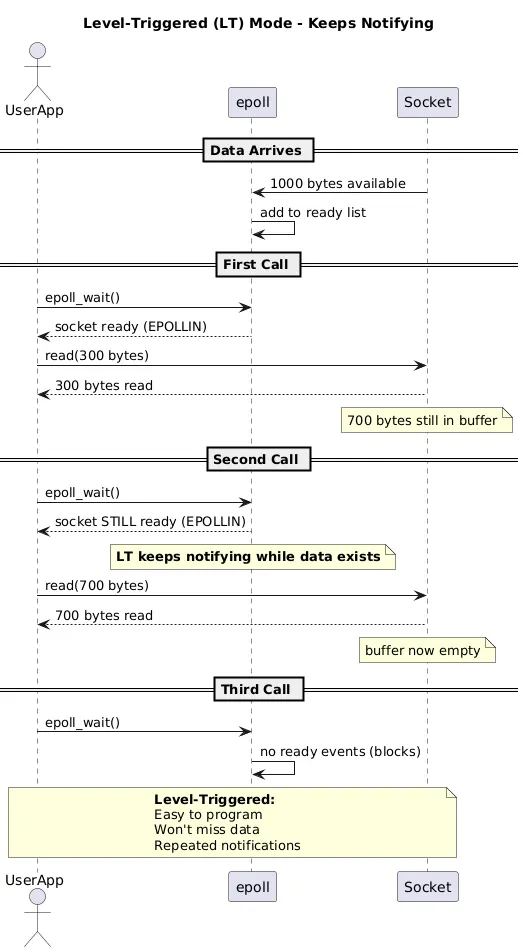
Schéma provenant de l’article Medium expliquant epoll et détaillant le fonctionnement du mode level-triggered
Le second mode est le mode edge-triggered (ET) et est activé par le flag EPOLLET.
Ici, vous n’êtes notifié qu’au changement d’état, c’est-à-dire au moment où le descripteur devient prêt.
Un scénario de bug assez classique consisterait en un client envoyant 2 Ko de données.
Notre serveur en mode ET est notifié, lit 1 Ko, et retourne dans epoll_wait.
Tant qu’aucun nouveau paquet n’arrive (donc aucun nouveau front montant), ce socket ne sera plus signalé, et le kilo-octet restant dort dans le buffer pendant que la connexion semble morte.
Ni erreur, ni timeout, c’est un blocage silencieux, l’un des types de bugs les plus pénibles à diagnostiquer.
D’où la règle du mode ET, énoncée par la man page epoll(7) qui précise que les descripteurs en non-bloquant sont obligatoires, et que la lecture doit s’effectuer en boucle jusqu’à recevoir EAGAIN.
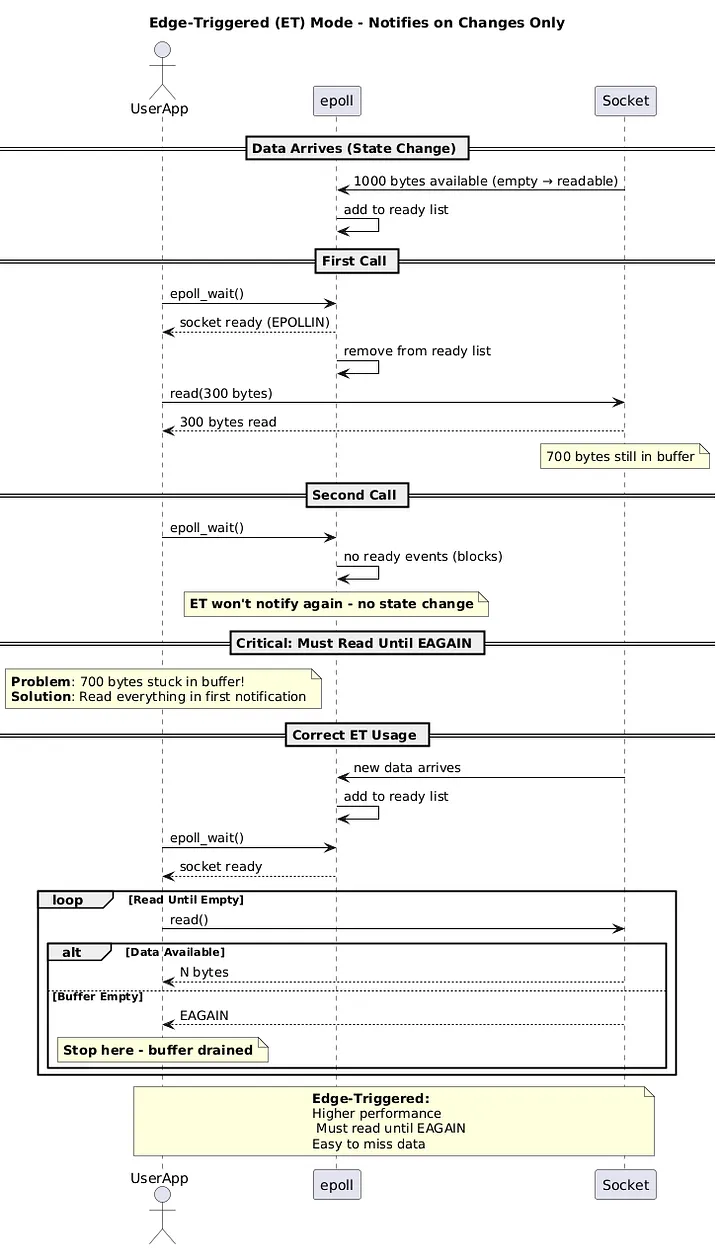
Schéma provenant de l’article Medium expliquant epoll et détaillant le fonctionnement du mode edge-triggered
Mais pourquoi s’infligerait-on l’utilisation du mode ET ?
Tout simplement parce qu’il génère moins de réveils.
ET génère par exemple une notification par rafale de données plutôt qu’une par appel.
De plus, le mode LT a un coût caché.
Pour pouvoir re-signaler un descripteur encore prêt, epoll doit revérifier son état et le maintenir dans la ready list, là où ET peut l’oublier dès qu’il a été notifié.
En contrepartie, ET introduit un risque de starvation, c’est-à-dire que si un socket très bavard vous fait lire en boucle jusqu’à EAGAIN, les autres descripteurs prêts attendent leur tour.
Une contre-mesure à cela consiste à donner une quantité maximale de données lues par descripteur et par tour de boucle, en tenant soi-même la liste des descripteurs « pas terminés ».
Voici un graphique mesurant les performances d’un serveur nommé μserver en utilisant différentes stratégies.
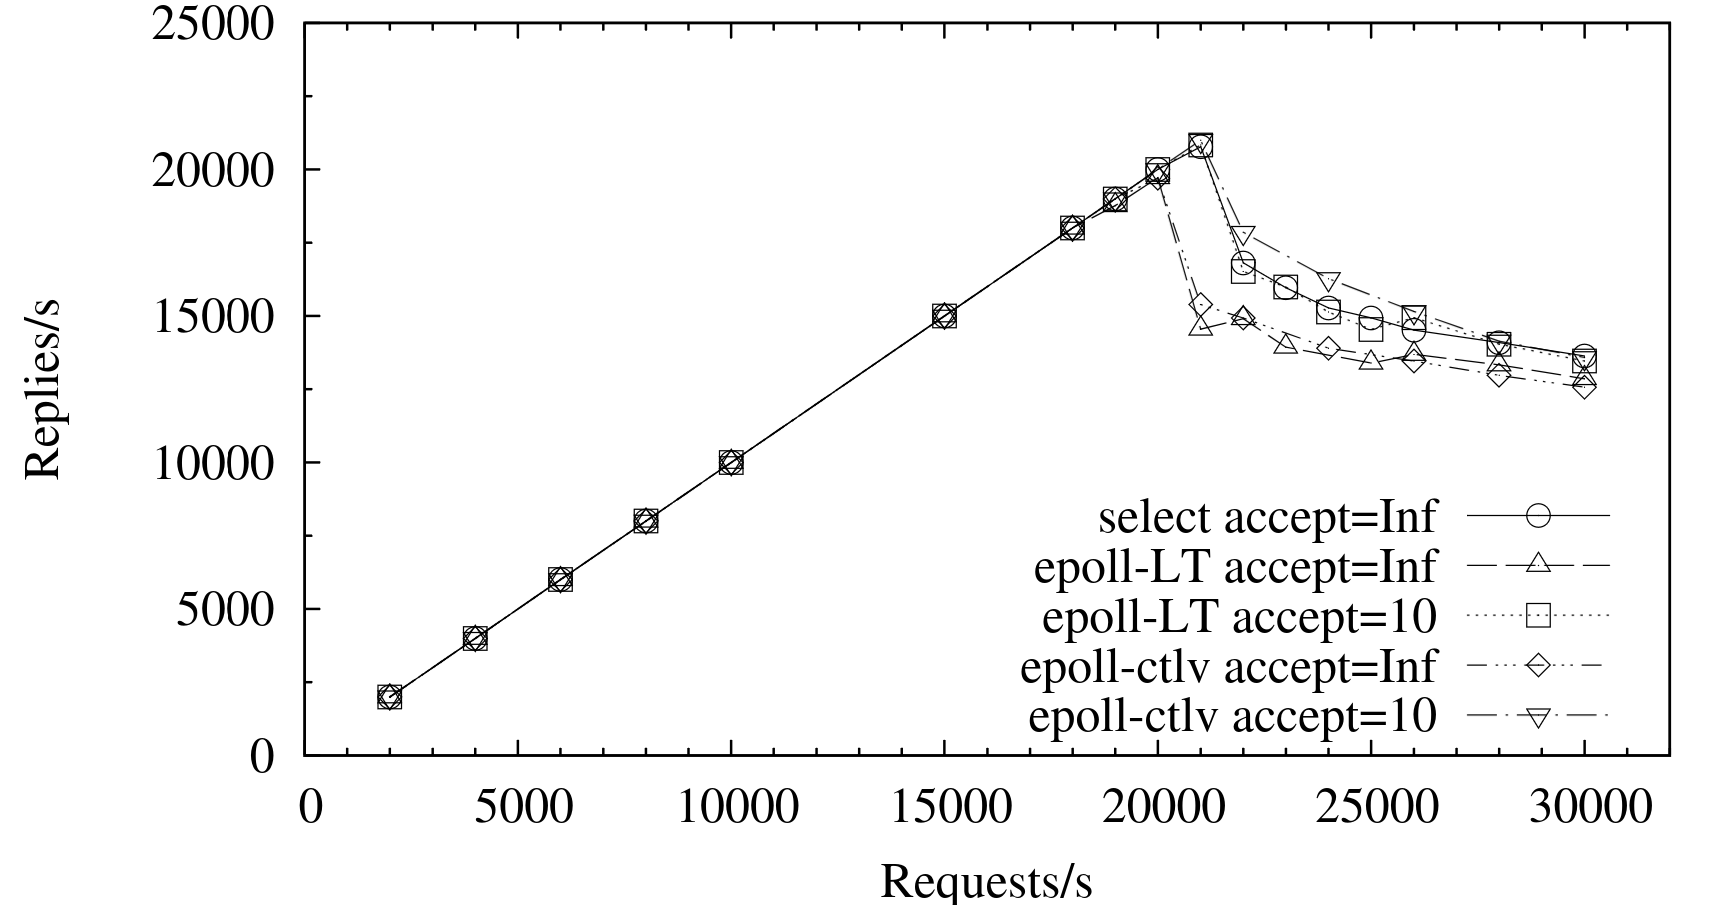 Performances de μserver sur une charge de travail d’un octet avec différentes stratégies d’acceptation et sans connexions inactives
Ce graphique provient directement d’une étude de l’université de Waterloo comparant et évaluant epoll, select et poll disponible via ce lien.
Deux autres pièges méritent d’être mentionnés ici.
Le premier est le thundering herd.
Si plusieurs processus (les workers d’un serveur par exemple) attendent sur le même socket d’écoute, une connexion entrante les réveille tous, alors qu’un seul pourra faire l’accept().
Les autres se sont réveillés pour rien.
Et lorsque le serveur se trouve sous haute charge ce gaspillage se mesure et se ressent concrètement.
Afin de remédier à cela, Linux 4.5 (2016) a ajouté le flag EPOLLEXCLUSIVE, qui demande au kernel de ne réveiller qu’un seul processus en attente.
Le second est un peu plus sournois.
En effet epoll n’enregistre pas un file descriptor, mais un file description (description de fichier).
C’est l’objet kernel sous-jacent, celui que dup() ou fork() partagent.
Une conséquence de cela est documentée dans la section Questions/Réponses de epoll(7) : si vous dupliquez un descripteur puis fermez l’original, l’enregistrement epoll survit, et vous continuez de recevoir des événements pour un descripteur que vous croyez fermé.
Le nettoyage automatique n’a lieu que lorsque toutes les références à la description ont été fermées.
epoll en pratique : 10 000 timers
Pour voir epoll fonctionner sans écrire de serveur TCP, il suffit d’utiliser un autre type de file descriptor, les timerfd.
timerfd_create() retourne un fd qui devient lisible quand son timer expire, et dont le read() renvoie le nombre d’expirations survenues sous la forme d’un entier non signé de 64 bits (d’où le uint64_t).
Le programme ci-dessous crée 10 000 timers qui expirent tous 2 secondes plus tard, et les enregistre une seule fois chacun avec epoll_ctl.
Il boucle ensuite sur epoll_wait jusqu’à avoir traité les 10 000.
Deux détails méritent un peu d’attention.
Premièrement, un processus possède par défaut une limite du nombre de file descriptors ouverts (souvent 1024).
La fonction setrlimit relève cette limite jusqu’au plafond autorisé, sans quoi timerfd_create échouerait.
La limite par défaut peut rappeler le FD_SETSIZE de select, mais ici c’est une politique du système, modifiable, et non une limite définie par l’API.
Par ailleurs, le tableau events n’est pas la liste des fds surveillés.
Cette dernière vit dans le kernel, et nous y avons enregistré les 10 000 timers.
C’est seulement un buffer dans lequel epoll_wait dépose les fds prêts, 1024 au maximum par appel.
|
|
Après avoir compilé et mesuré avec la commande time, on obtient :
$ gcc -std=c99 -pedantic -Werror -Wall -Wextra -Wvla -o timer timer.c
$ time ./timer
epoll_wait :  101 timers prêts (total   101 / 10000)
epoll_wait :  320 timers prêts (total   421 / 10000)
epoll_wait :  436 timers prêts (total   857 / 10000)
epoll_wait :  606 timers prêts (total  1463 / 10000)
epoll_wait :  848 timers prêts (total  2311 / 10000)
epoll_wait : 1024 timers prêts (total  3335 / 10000)
[...]
epoll_wait : 1024 timers prêts (total  9479 / 10000)
epoll_wait :  521 timers prêts (total 10000 / 10000)

real	0m2.037s
user	0m0.006s
sys	0m0.055s
Ici, un seul thread a surveillé 10 000 descripteurs, et chaque appel à epoll_wait n’a renvoyé que des timers déjà expirés.
Aucun n’a été perdu ni traité deux fois, et le programme n’a presque pas consommé de CPU.
En effet, real vaut environ deux secondes, soit exactement le délai des timers, tandis que user et sys totalisent environ 0,06 seconde.
Le reste du temps, le thread « dort » dans epoll_wait.
On remarque facilement que les premiers lots sont plus petits que 1024.
Ceci est dû au fait que les timers n’ont pas tous été créés au même instant.
La boucle de création prend quelques dizaines de millisecondes, et leurs expirations sont étalées d’autant.
epoll_wait se réveille dès les premières expirations, alors que les suivantes n’ont pas encore eu lieu.
Ces premières lignes peuvent donc varier d’une exécution à l’autre.
Notez enfin que cet exemple utilise le mode par défaut, level-triggered.
Avec EPOLLET, il faudrait utiliser des fds non bloquants et lire jusqu’à recevoir EAGAIN pour ne pas rater d’événements.
De epoll à l’event loop
Un mécanisme kernel ne sert les utilisateurs qu’à travers une architecture logicielle, et celle qui s’est imposée autour d’epoll porte un nom, c’est le reactor pattern.
Son squelette tient en trois étapes.
Premièrement une boucle infinie appelle epoll_wait.
Ensuite, pour chaque événement reçu, elle invoque le handler associé au descripteur (accepter une connexion, lire une requête, écrire un morceau de réponse).
Enfin, elle recommence. Mais cela forme une contrainte fondamentale, un handler ne doit donc jamais bloquer, car il bloquerait tout le monde.
C’est le prix du thread unique, et la raison pour laquelle tout l’écosystème doit être asynchrone lui aussi.
Trois exemples montrent la portée du modèle. nginx, publié en 2004 et explicitement conçu en réponse au C10K, lance un processus worker par cœur CPU.
Chaque worker est une boucle epoll qui gère à elle seule des milliers de connexions.
La comparaison avec l’Apache de l’époque et son modèle à processus résume vingt ans d’évolution des serveurs web.
Node.js repose sur la bibliothèque libuv, qui est précisément une abstraction portable au-dessus d’epoll (kqueue sur macOS et FreeBSD, IOCP sur Windows).
En vérité le fameux modèle « JavaScript asynchrone à callbacks » n’est rien d’autre que la sémantique d’epoll remontée jusqu’au langage.
Redis, enfin, a servi pendant des années des centaines de milliers de requêtes par seconde avec un unique thread, grâce à sa petite boucle d’événements maison basée sur epoll.
Conclusion : les limites du modèle readiness
Pour finir, on peut alors se demander si epoll a réellement résolu le problème C10K.
La réponse la plus courte est… oui, mais seulement sur Linux, et pas tout seul.
En effet l’implémentation de kqueue l’avait précédé de deux ans sur FreeBSD par exemple, ou bien même Solaris avec /dev/poll.
Mais c’est le couple mécanisme kernel + architecture réacteur, incarné par nginx, qui a réellement enterré le problème.
Ironie de l’histoire, le modèle thread-par-connexion lui-même a été largement réhabilité depuis, par NPTL et l’ordonnanceur O(1) du kernel 2.6, au point que 10 000 threads sont aujourd’hui parfaitement viables.
epoll a résolu le C10K de 1999, avec le hardware et les kernels de 1999.
Le seuil limite s’est depuis déplacé, et on parle alors du problème C10M, les 10 millions de connexions simultanées.
Et sur ce nouveau front, epoll montre ses limites.
C’est un modèle de readiness, c’est-à-dire qu’il vous dit quand agir, mais chaque action reste un appel système avec des syscalls read, write, accept dont le coût a augmenté avec les correctifs déployés contre les vulnérabilités Spectre/Meltdown.
Et il ignore les fichiers ordinaires, toujours « prêts » au sens de poll, même quand la lecture va bloquer sur le disque.
io_uring, introduit en 2019, répond aux deux avec un modèle de completion : on soumet des opérations dans une file partagée avec le kernel, qui notifie leur achèvement.
Mais ça, c’est une autre histoire et peut-être un autre article.
Bibliographie
- Dan Kegel, The C10K problem, kegel.com/c10k.html.
- Man pages Linux :
epoll(7),select(2),poll(2). La man pageepoll(7)contient le scénario détaillé du mode edge-triggered et la Q&A sur les descripteurs dupliqués. - Wikipedia, https://en.wikipedia.org/wiki/Epoll. Page Wikipedia de
epoll. - Louay Gammo, Tim Brecht, Amol Shukla, and David Pariag, Comparing and Evaluating epoll, select, and poll Event Mechanisms, Comparing and Evaluating epoll, select, and poll Event Mechanisms.
- Meriah Abderrahim, Mastering epoll: The Engine Behind High-Performance Linux Networking, Medium.com, 2025, The Engine Behind High-Performance Linux Networking.
- Oleksiy Kovyrin, Using epoll() For Asynchronous Network Programming, https://kovyrin.net/2006/04/13/epoll-asynchronous-network-programming/. Petit article expliquant l’utilisation d’epoll.
- Michael Kerrisk, The Linux Programming Interface, Chapitre 63, « Alternative I/O Models » : comparaison systématique de select, poll, signal-driven I/O et epoll, avec mesures de performance.
- Jonathan Corbet, Epoll evolving, LWN.net, lwn.net/Articles/633422. Le problème du thundering herd et la genèse d’
EPOLLEXCLUSIVE. - Le code source :
fs/eventpoll.cdans l’arbre du kernel Linux, pour les structureseventpolletepitemet la fonctionep_poll_callback.
Pour aller plus loin
- The edge-triggered misunderstanding, LWN.net, 2021, lwn.net/Articles/865489. Pour creuser le fonctionnement exact du mode edge-triggered.
- Marek Majkowski, Epoll is fundamentally broken (1/2, 2/2), 2017. Une critique argumentée d’epoll où la seconde partie dissèque le piège file descriptor / file description évoqué en section 5.
- Andrew Alexeev, nginx, dans The Architecture of Open Source Applications, vol. 2, aosabook.org/en/v2/nginx.html. L’architecture de nginx racontée de l’intérieur, conçue explicitement en réponse au C10K.
- Design overview de libuv, docs.libuv.org/en/v1.x/design.html. Comment la boucle d’événements de Node.js abstrait epoll, kqueue et IOCP.
- Man page Linux :
io_uring(7), et Shuveb Hussain, What is io_uring?, Lord of the io_uring, unixism.net/loti/what_is_io_uring. Le modèle completion qui succède au modèle readiness. - Meltdown and Spectre, Meltdownattack.com, https://meltdownattack.com/. Papiers de recherche sur les vulnérabilités Spectre et Meltdown.
-
Le site ftp.cdrom.com n’existe plus aujourd’hui mais c’était un serveur FTP célèbre et extrêmement fréquenté dans les années 1990. Il était géré par l’entreprise américaine Walnut Creek CDROM et proposait une immense collection de logiciels libres, shareware, jeux et archives (comme les mods pour Doom). Ce service a fermé en 2001. Mais actuellement, le lien redirige vers … une page LinkedIn ! ↩︎